AI·플레이 데이터 기반 경쟁 게임의
공정성·재현성 검증
2026 SCHU AI·SW Festival · AI·SW 프로젝트 경진대회 · 지도교수 안호연 · 이학주(20253762), 김보민(20253758) · 메타버스&게임학과
▶ 검증 실험실: 브라우저에서 직접 돌려 보기 (에이전트 대회, 프레임레이트 실험, 직접 플레이, 아무 사이트 QA 점검)
핵심 질문
경쟁 게임에서 “점수 규칙이 공정한가, 다시 해도 같은 결과가 나오는가”를, 실력이 다른 AI 에이전트의 플레이 데이터로 가설 → 실험 → 분석 → 개선하며 검증할 수 있는가?
모든 수치는 사람이 아니라 합성 AI 에이전트(반응 지연·실수·전략을 규칙으로 정한 플레이어)의 결과입니다. 사람 데이터 수집은 후속 과제입니다.
검증 대상
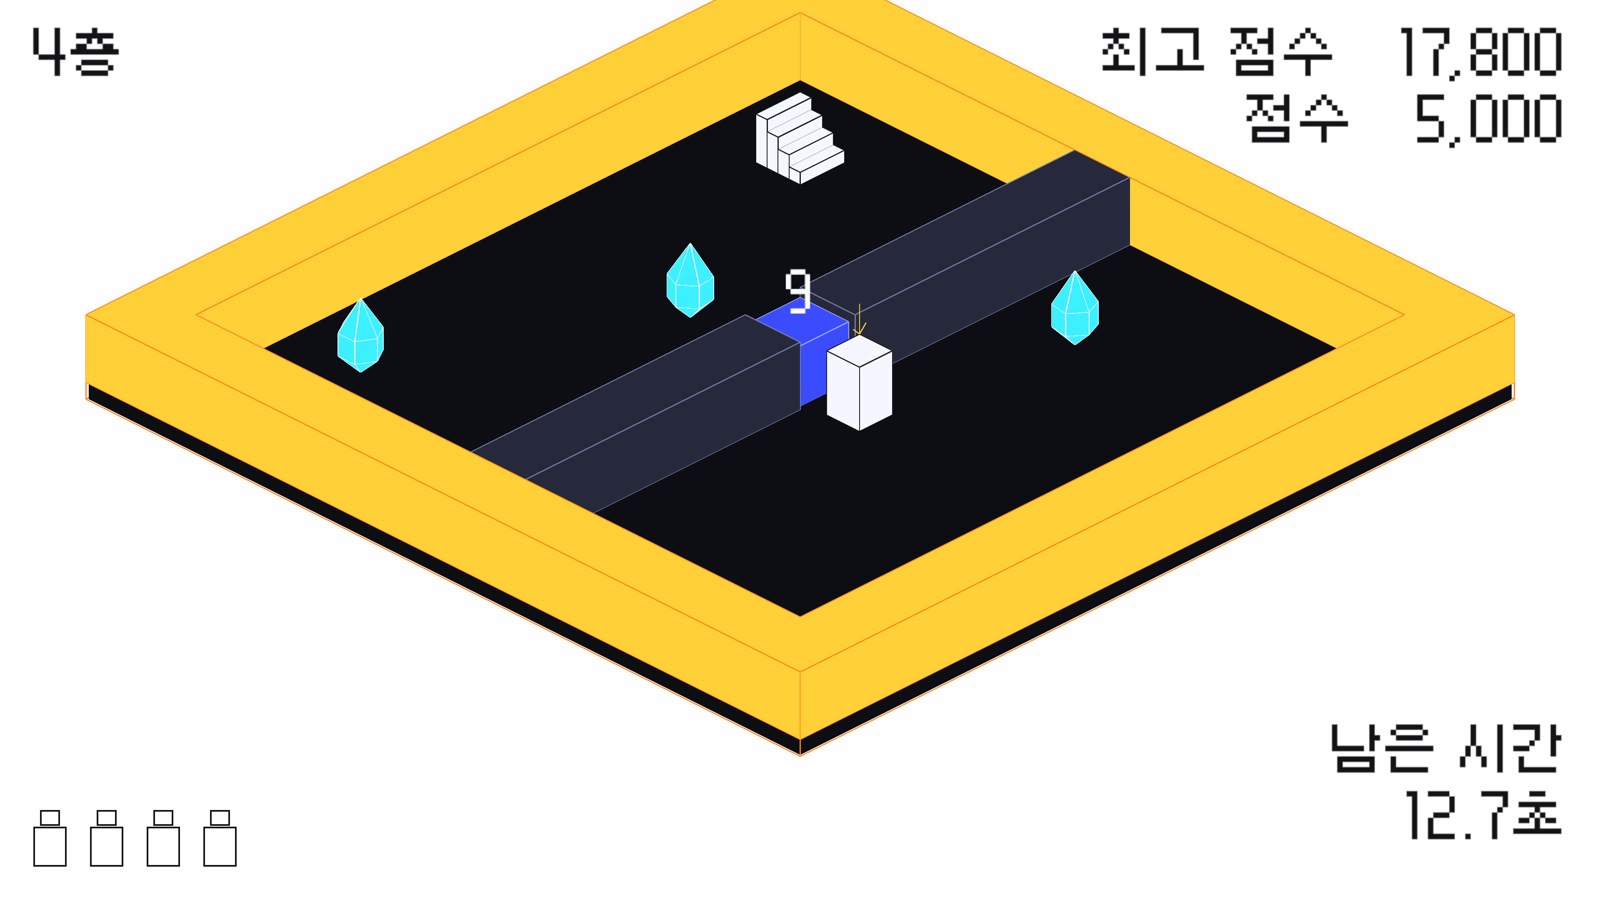
- 「2분 전의 나」 (자작): 20초마다 시간이 되감기고 직전의 내가 분신이 되어 협동하는 7층 탑 등반 게임. Unity 6, 50Hz 결정론 시뮬레이션. 순위 서버·순위표
- 유명 게임 3종: Flappy Bird · Chrome Dino Run · 2048 — 규칙만 직접 재현 구현(원본 에셋·코드 없음)
- 실제 웹사이트 QA: YouTube · 티스토리(메인, 블로그) · 네이버 블로그, 순천향대 홈페이지 2곳
Q1 난이도: 실력이 높아도 점수가 단조롭게 오르지 않는다
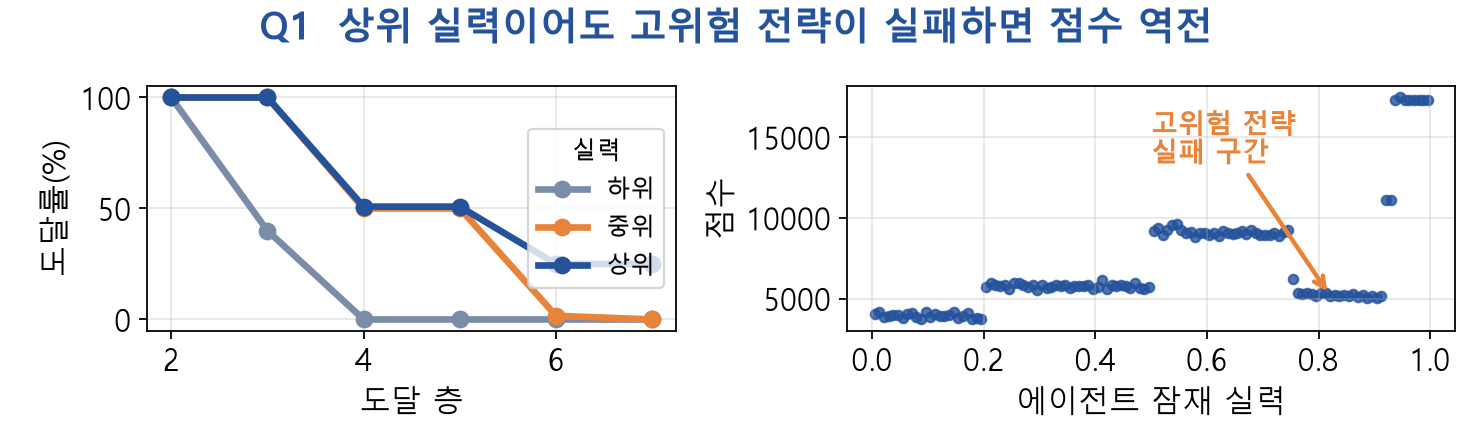
실력 0.75~0.9 구간의 에이전트는 분신 협동 같은 고위험 전략이 실패하면 0.5~0.7 구간보다 점수가 낮았습니다(3회 평균 약 5,000점 대 약 9,000점). 전략 구간이 계단 모양 점수를 만든 부분은 에이전트 설계의 영향도 있습니다.
Q2 점수 규칙: 3회 최고점은 운 요소가 큰 게임에서만 순위 정확도를 높인다
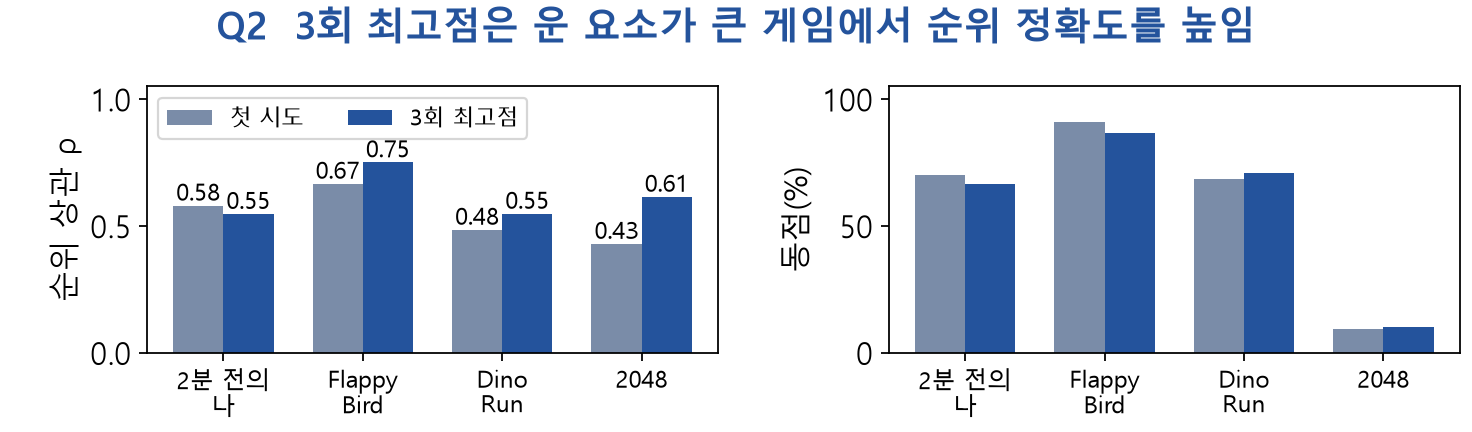
| 게임 | 첫 시도 ρ | 3회 최고점 ρ |
|---|---|---|
| 2분 전의 나 (고정 맵) | 0.58 | 0.55 |
| Flappy Bird | 0.67 | 0.75 |
| Dino Run | 0.48 | 0.55 |
| 2048 | 0.43 | 0.61 |
ρ는 에이전트의 잠재 실력과 점수 순위 사이의 Spearman 상관입니다(120명 × 3회). 「2분 전의 나」는 맵이 고정이라 3회 기회가 순위를 더 정확하게 만들지 못했고, 동점자 비율(약 67~70%)이 높아 동점 규칙 보강이 필요합니다.
Q3·Q5 프레임레이트와 분신 재생
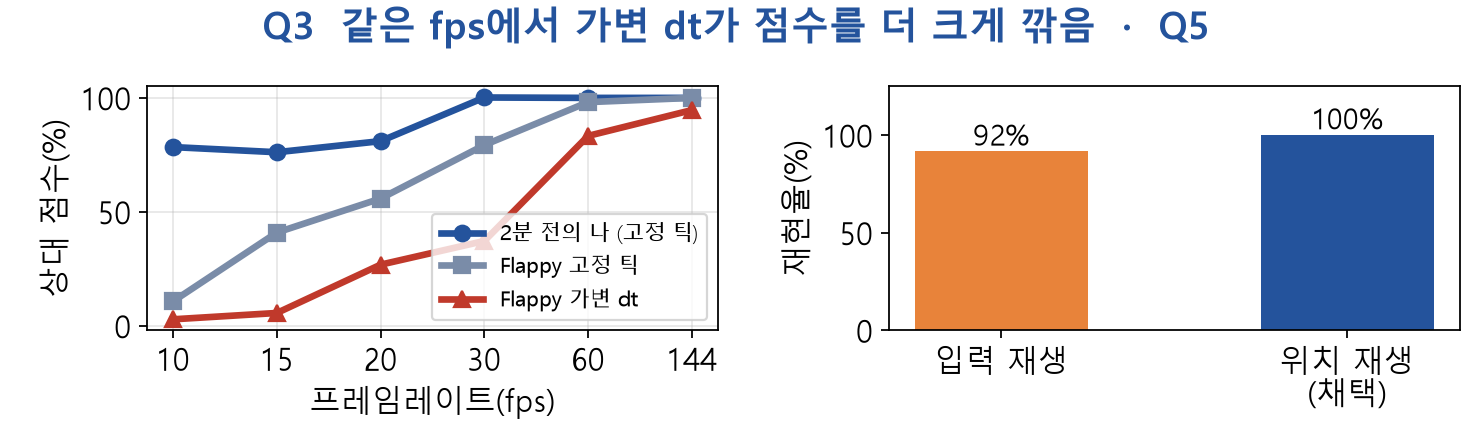
- 같은 fps에서 Flappy Bird의 프레임 의존(가변 dt) 물리는 점수를 더 크게 깎았습니다. 30fps에서 고정 틱은 최고 점수의 79%, 가변 dt는 37%였습니다.
- 「2분 전의 나」는 10fps에서도 약 78%를 유지했습니다.
- Dino Run의 가변 dt는 10·15fps에서 결과가 불규칙해 그래프에서 뺐습니다(원자료에는 있음).
- 분신을 입력 재생으로 만들면 블록이 이미 부서진 경우 원래 층 재현율이 92%(55/60), 위치 재생(채택)은 100%였습니다.
Q6 실제 서비스 QA
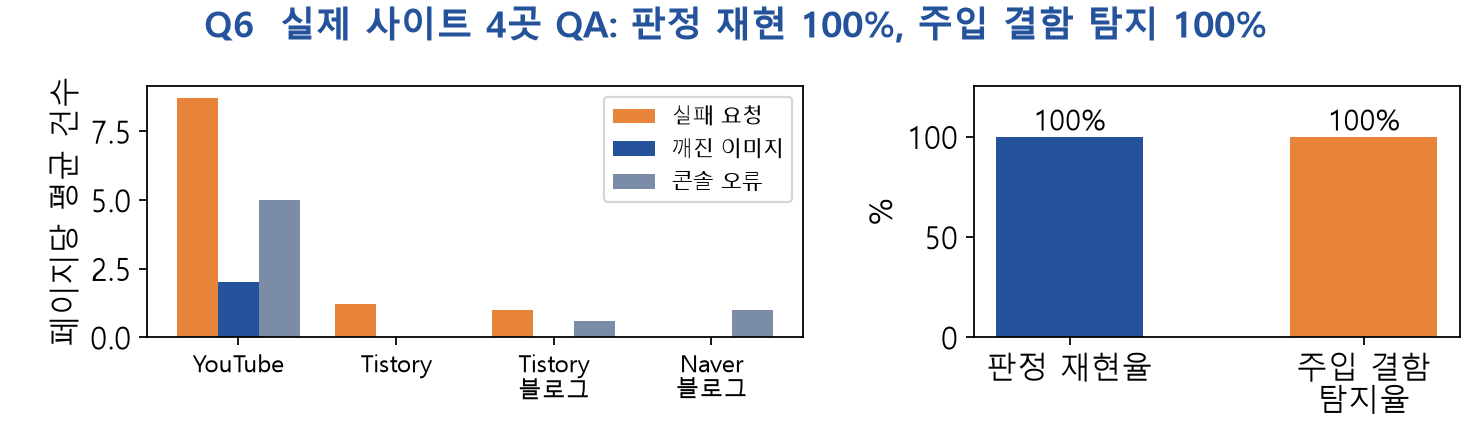
- 4곳 × 화면 폭 3종 × 3회, 36회 모두 정상 완료. 같은 조건 반복에서 결함 유무 판정은 100% 일치.
- 일부러 넣은 결함 6종(깨진 이미지, 가로 넘침, 빈 링크, 이름 없는 버튼, alt 누락, 콘솔 오류)을 4곳 모두에서 전부 탐지.
- 콘솔 오류·실패 요청 건수와 로딩 시간은 반복마다 흔들렸습니다(YouTube 콘솔 오류 1~7건). “판정”은 재현되지만 “건수”는 재현되지 않습니다. 가로 넘침은 의도된 가로 스크롤일 수 있어 후보 결함으로만 봅니다.
- 순천향대 홈페이지는 자동화 브라우저에 403을 돌려줘서, 일반 브라우저로 소수 횟수만 읽기 전용으로 점검했습니다. 학교 평가가 아니라 같은 방법이 쓸 만한 항목을 찾는지 확인하는 용도입니다.
한계와 후속 과제
- 「2분 전의 나」 실험은 7층 고정 타워 버전에서 측정했습니다. 이후 무한 타워로 규칙이 바뀌어, 새 버전 결과는 다시 측정해야 합니다.
- 사람 플레이 데이터 없음: 현장 예선 기록으로 에이전트를 보정할 예정.
- Q4(에이전트 구조 FSM/BT/효용 AI 비교)는 아직 수행하지 않았습니다.
- 유명 게임 3종은 규칙을 단순화한 재현 구현이라 원본과 수치가 같지 않습니다.